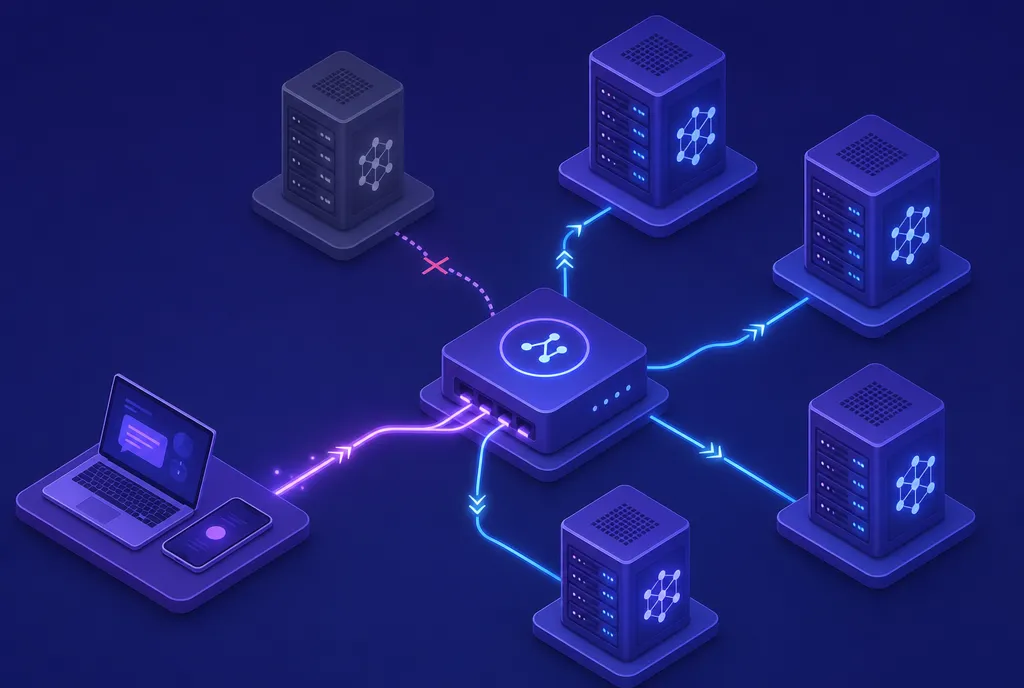
过去一周 AI 圈最热的话题之一,不是某个参数更大的模型,而是一个「不干活、只派活」的模型。
9 月 11 日,由 Transformer 论文八位作者之一 Llion Jones 参与创立的东京实验室 Sakana AI,发布了 Fugu 家族的新成员 Fugu Max。它的定位很反常:你自己的请求发给一个端点,背后却是一个编排器(orchestrator)——一个专门训练过「怎么分工」的小模型,实时决定这个任务该拆给池子里的哪个模型做,最后把结果缝合起来还给你。9 月 14 日的 Agentic 周刊把它评为本周最有代表性的发布:「一个产品,全部价值在于决定别人的模型该干你的活。」
本文把这件事讲透:它和普通大模型到底有什么本质区别、Fugu 家族四款怎么选、怎么写代码接入,以及定价表背后三个会悄悄吃掉预算的坑。
一、Fugu Max 到底是什么:你调用的是一个调度器
先建立一个心智模型。普通大模型是「一个脑子读完你的输入、写出答案」;Fugu Max 是「一个工头看着你提交的活,把它拆成几道工序,每道工序挑池子里最便宜但能胜任的工人,验收后拼成成品交给你」。
这个「工头」不是规则引擎,而是用强化学习训练出来的协调模型,Sakana 把它的方法论发表在了两篇 ICLR 2026 论文里:TRINITY 让一组 LLM 在多轮对话中自动分配思考者(Thinker)、执行者(Worker)、校验者(Verifier)三种角色;Conductor 则让协调策略本身被「学」出来而不是手写。最狠的一点是它能递归调用自己——拆出来的子任务如果还太复杂,子任务里可以再开一个工头。
对开发者来说,这一切藏在同一个 OpenAI 兼容端点后面:你拿到的收益是多模型系统的质量,付出的维护成本却是单模型 API 的成本。
二、Fugu 家族四兄弟:一个端点,一行参数切换
Fugu 全系共用一个 API,切换模型只是改 model 字段的一行字符串:
| 型号 | 定位 | 输入/百万 Token | 输出/百万 Token | 适合谁 |
|---|---|---|---|---|
| Fugu | 均衡款,日常默认 | 中端 | 中端 | 编码工具(如 Codex)里的常规任务 |
| Fugu Max | 成本性能比优先,池子最大 | $2.00 | $6.00 | 大批量、预算敏感的生产任务 |
| Fugu Ultra v2 | 质量优先,难题攻坚 | $5.00(>272K 上下文 $10) | $30.00(>272K 时 $45) | 高风险复杂推理 |
| Fugu Cyber | 安全专项(漏洞研究等) | 专项定价 | 专项定价 | 安全团队 |
两个 Max 的数字值得单独记住:
- 100 万 Token 上下文,文本、图片、PDF 都能直接喂;
- 价格与上下文长度无关——90 万 Token 的长文档和一句话的每 Token 单价一样,这在长上下文普遍加收「超长附加费」的今天是少见的。
三、API 接入:和调 OpenAI 没有区别
以 OpenAI Python SDK 为例,把 base_url 指向 Sakana 端点即可:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_SAKANA_API_KEY",
    base_url="https://api.sakana.ai/v1",  # Sakana Fugu 端点
)

resp = client.chat.completions.create(
    model="fugu-max",               # 换成 fugu / fugu-ultra / fugu-cyber 即切换家族成员
    messages=[
        {"role": "system", "content": "You are a careful code reviewer."},
        {"role": "user", "content": [
            {"type": "text", "text": "Review this module and list the three riskiest spots:"},
            {"type": "file", "file": {"file_data": "https://example.com/module.py"}},
        ]},
    ],
    reasoning_effort="high",        # 可选:high / xhigh / max
    # response_format={"type": "json_object"},  # 结构化输出同样支持
)
print(resp.choices[0].message.content)
Node.js 侧同理,new OpenAI({ baseURL: "https://api.sakana.ai/v1", apiKey }) 之后照常调用。函数调用(function calling)、结构化输出、内置联网搜索($0.007/次)都是标配。
四、账单上的三个坑,官方不会替你算
Fugu Max 的标价是真便宜——输入 $2、输出 $6、缓存命中输入只要 $0.25。但有三个机制会让实际账单偏离直觉:
1. 编排 Token 照常计费。 你的一个请求在池子里扇出成多个子任务时,工头之间通信、子模型读写、校验回读的 Token 全部计入你的账单。Sakana 的缓解政策是「不叠加收费,按涉及的最高档模型单一费率计」,但「每 Token 便宜」不等于「每个答案便宜」。一个扇出 5 个代理的复杂请求,实际消耗可能是单模型调用的数倍。
2. 缓存命中率决定真实成本。 OpenRouter 上架头几天的实测面板显示,Fugu Max 的加权实际输入价约 $0.61/百万(对比 $2 牌价),靠的是 79% 以上的缓存命中率——说明池子内部对重复上下文复用得相当激进。这对「多轮对话、重复喂系统提示」的场景是利好;对每次都是全新长文档的场景,你要按牌价做预算。
3. 路由不透明,你审计不了。 Sakana 不会告诉你某个请求实际用了池子里哪些模型。对合规敏感、需要向客户解释「数据经过了什么模型」的团队,这是硬约束,选型前要先想清楚。
五、冷静看待它的基准测试
官方口径是 Fugu Max 在六个基准上拿到最佳综合分、十个基准里七个扩展了成本-性能帕累托前沿。看这类数字时记住三条:SWEFish 是 Sakana 自建的内部基准;旗舰模型(Fable 5.1、GPT-6 Astra)不在它的池子里,「以开源池中档模型打败旗舰价」正是它的卖点而非心虚;以及所有分数都是厂商自报。Hacker News 上对 Fugu 家族最尖刻的评论是「你已经在给 Anthropic、OpenAI、Google 各交 $200/月,现在再交 $200 给 Sakana 替你把它们拧到一起」——反过来也有真实用户报告,把 Fugu Ultra 当顾问、更快的模型当执行者的组合「值得,前提是你的工具链能把顾问和执行者分开」。
六、什么团队现在就该试,什么团队再等等
值得立刻试的:调用量大、任务杂、已经在手动维护「哪个任务用哪个模型」路由表的团队——Fugu Max 把这条路由层做成了托管服务,$2/$6 的扁平价让成本预测非常简单。长文档场景(百万上下文不涨价)也明显受益。
建议再等等的:对输出可审计性有硬要求的行业(金融合规、医疗)、任务类型单一且已锁定最优模型的团队(你自己调一个模型反而更便宜),以及需要指定池子成员的场景——注意 Max 的池子是固定的,不能自选(家族基础款可以)。
小结
Fugu Max 代表了一个清晰的行业信号:模型层正在像数据库层一样「基础设施化」——它很重要、很贵,但你卖给客户的不再是它,而是它上面的调度、工具与流程。如果你的痛点是「任务太杂、模型太多、账单太散」,花半天时间把一条非关键业务流量切到 Fugu Max 上跑一周,对照自己手工路由的成本和质量,数据会给你答案。