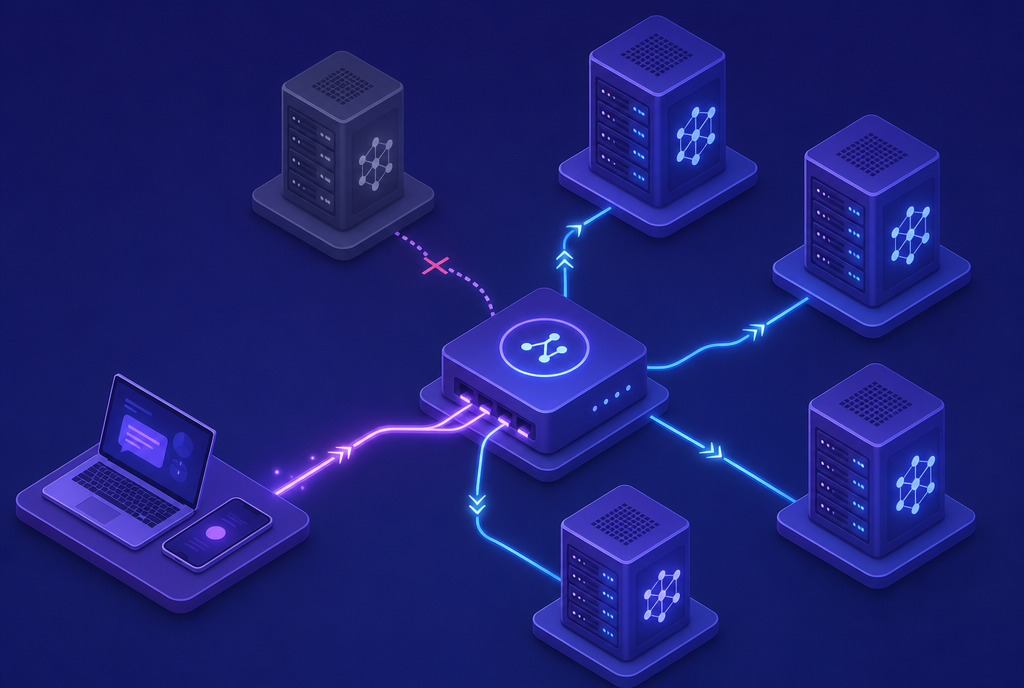
过去一周的 AI 圈有两条新闻值得连起来看:一是 Kimi 新模型 K3 因访问量过大暂停了新用户订阅,二是 OpenAI 在 ChatGPT 里升级了 GPT-5.6 Sol 档位,把产品重心从"问答"推向"任务完成"。再往前翻,几乎每个主流厂商今年都经历过至少一次区域性故障或配额收紧。结论很简单:大模型服务正在变成一种会拥堵、会涨价、会临时调整策略的基础设施。
如果你的工作流——不管是自己写的小工具、公司的客服机器人,还是跑在服务器上的自动化脚本——只接了一家的 API,那么对方的每一次限流、改版、维护,都是你的事故。这篇文章讲清楚怎么给自己搭一套"备胎系统":平时无感,出事时秒切,成本还可控。
一、先想清楚:你需要哪种级别的备胎
不是所有场景都值得上重方案。按故障的容忍度分三档:
| 场景 | 可接受中断时长 | 推荐方案 |
|---|---|---|
| 个人工具、实验脚本 | 几分钟到几小时 | 第一层:手动切换 |
| 内容生产、内部自动化 | 几十秒 | 第二层:代码级自动切换 |
| 面向用户的产品、关键业务 | 秒级,且要可观测 | 第三层:统一网关 + 监控 |
大多数人处在第一、二层之间。建议直接从第二层做起——代码量不大,一次写好长期受益。第三层适合已经有多人、多项目共用 API 的团队。
二、第一层:十分钟就能搞定的手动备胎
最低成本的方案,适合不想写代码的人:
- 同时持有两家以上厂商的账号和 key。选择标准很简单:主用一家,备用一家协议兼容的。目前绝大多数国产模型(Kimi、DeepSeek、通义、智谱等)都提供 OpenAI 兼容接口,换模型基本只改
base_url、api_key和模型名三个值。 - 把配置写成环境变量而不是硬编码。比如
LLM_BASE_URL、LLM_API_KEY、LLM_MODEL。限流发生时改三个环境变量重启服务,比翻代码快得多。 - 备一个聚合 API 账号作为"最后备胎"。聚合平台一个 key 能调几十家模型,虽然单价略高,但胜在永远不会"全家都挂"。平时不用,出事时顶上去。
这一层的短板很明显:切换靠人发现、靠人操作,半夜出问题就要半夜爬起来。所以要往上走一层。
三、第二层:代码级自动故障转移(核心实战)
思路一句话:按优先级配置一个模型列表,请求失败时自动降级到下一个,全部失败才报错。下面是一个可以直接用的 Node.js 实现(用 OpenAI 官方 SDK,因为兼容协议最通用):
import OpenAI from "openai";

// 按优先级排列:主模型在前,备胎在后
const PROVIDERS = [
  {
    name: "primary",
    baseURL: process.env.LLM_BASE_URL,        // 主厂商
    apiKey: process.env.LLM_API_KEY,
    model: process.env.LLM_MODEL,
  },
  {
    name: "backup-1",
    baseURL: process.env.LLM_BACKUP_BASE_URL, // 备用厂商
    apiKey: process.env.LLM_BACKUP_API_KEY,
    model: process.env.LLM_BACKUP_MODEL,
  },
];

// 这些错误值得切换备胎:限流、服务端错误、超时、配额用尽
const RETRYABLE = [429, 500, 502, 503, 504];

async function chatWithFailover(messages, options = {}) {
  let lastError;
  for (const p of PROVIDERS) {
    const client = new OpenAI({ baseURL: p.baseURL, apiKey: p.apiKey, timeout: 30_000 });
    try {
      const res = await client.chat.completions.create({
        model: p.model,
        messages,
        ...options,
      });
      if (p.name !== "primary") {
        console.warn(`[failover] 主模型不可用,已由 ${p.name} 接管`);
      }
      return res;
    } catch (err) {
      lastError = err;
      const status = err?.status;
      if (!RETRYABLE.includes(status) && status !== undefined) {
        throw err; // 400 这类错误是自己请求有问题,换模型也没用,直接抛
      }
      console.warn(`[failover] ${p.name} 失败(${status ?? err.message}),尝试下一个`);
    }
  }
  throw lastError;
}
这段代码里有几个容易踩坑的细节,值得单独说:
- 不是所有错误都该切换。400(请求格式错误)、401(key 失效)换了厂商也一样失败,盲目重试只会浪费钱。只对 429(限流)和 5xx(服务端故障)做转移。
- 不同厂商的模型能力不对等。备胎模型的输出风格、上下文长度、工具调用能力可能和主模型有差异。降级时最好在日志里打标,方便事后排查"那天为什么输出质量下降了"。
- 超时必须设。不设 timeout 的话,主厂商挂起时你的请求会一直挂着,备胎永远轮不到。
- prompt 里不要写死厂商特有指令。比如某些模型特有的系统提示词约定,写死了会让备胎模型表现异常。
如果用的是 Python,思路完全一样:OpenAI SDK 的 base_url 参数 + 一个 for 循环即可,不赘述。
四、第三层:自建统一网关,一次解决所有项目
当你有三个以上的项目都在调大模型,在每个项目里复制一份 failover 代码就变得很蠢。这时候该把切换逻辑收敛到一个网关里。开源社区最常用的是 One API / New API 这类项目,部署一个就拥有:
- 统一的 OpenAI 兼容入口,所有项目只填一个地址、一个 key;
- 渠道(channel)级别的优先级与自动禁用:某个渠道连续失败会被自动摘下,恢复后再加回;
- 按模型名路由:
gpt-5.6走 A 厂商,k3走 B 厂商,调用方无感知; - 用量统计与额度管理,团队多人共用时分账清楚。
部署用 Docker 一行起,数据用 SQLite 就能跑,个人服务器完全够用:
docker run -d --name llm-gateway -p 3000:3000 -v /opt/llm-gateway/data:/data --restart always calciumion/new-api:latest
起好之后在 Web 后台添加各家厂商渠道、设置优先级,然后把所有项目的 base_url 指向 http://你的服务器:3000/v1 即可。之后再新增备胎厂商,业务代码一行都不用改。
需要提醒:自建网关意味着所有厂商的 key 都集中在一台机器上,务必给网关加访问令牌、不要把端口裸奔在公网,最好只允许内网或指定 IP 访问。
五、注意事项与常见问题
1. 切换备胎后上下文还连续吗? 连续。多轮对话的历史消息是你自己传给 API 的,换厂商不影响会话内容。但要注意各家对 system prompt 的处理细节略有差异,关键指令在消息里显式重复一次更稳。
2. 成本会不会失控? 备胎一般是"用时才计费",平时零成本。真正要防的是故障转移触发后的循环重试——上面的代码每个请求最多遍历一遍列表,不会在故障期间放大请求量。
3. 流式输出(stream)怎么处理? 流式场景下故障可能发生在传输中途,此时换厂商重发会导致用户看到内容重复。工程上常见的做法是:建连失败才切换,传输中断则就地报错让前端重试。
4. 厂商协议不兼容怎么办? 优先选提供 OpenAI 兼容接口的备胎。实在不兼容的,用 LiteLLM 这类代理库做协议抹平,比自己在业务代码里写分支干净。
5. 多久演练一次? 建议每季度手动把主模型 key 改错一次,确认备胎真的接得上。备胎方案最常见的失败模式是"配好了从来没测过,真出事时发现 key 早过期了"。
小结
模型侧的拥堵和策略变动只会越来越频繁——今天是 Kimi 暂停新订阅,明天可能是任何一家。应对思路归纳成三句话:配置外置,让手动切换足够快;代码里写好失败降级,让自动切换不靠人;项目多了就把逻辑收进网关,一处维护全局受益。从第二层的代码做起,一个下午就能搭完,换来的是以后再看到"某某模型限流"的新闻时,可以安心划走。