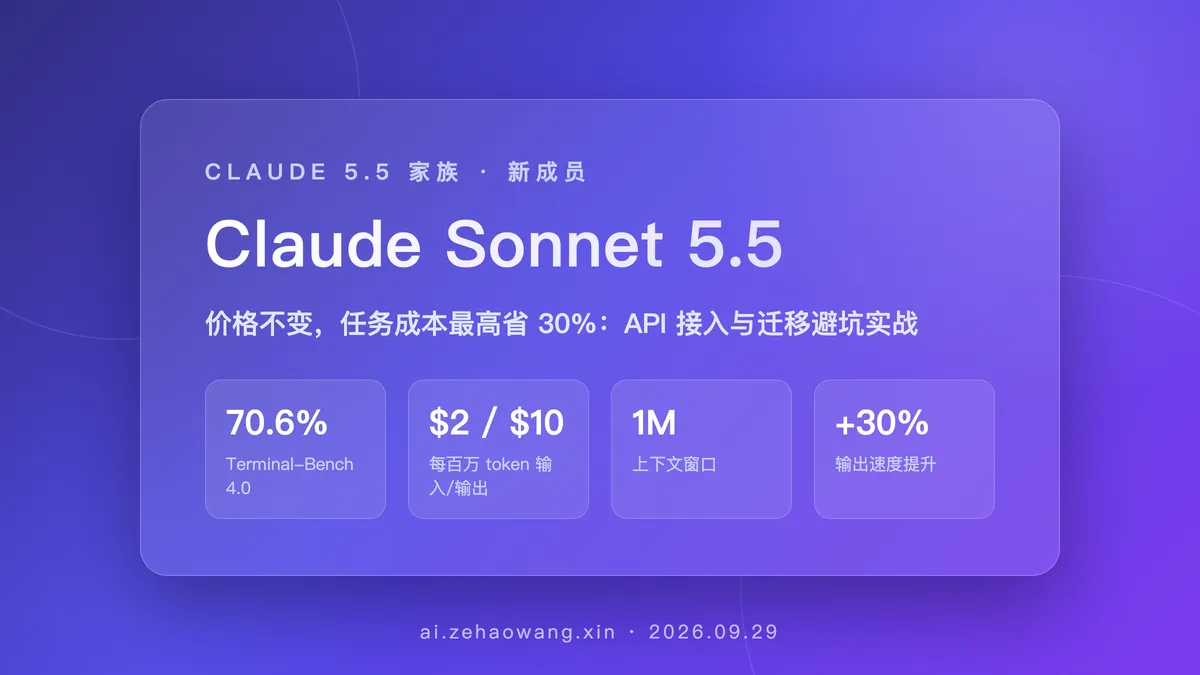
9 月 28 日,Anthropic 发布了 Claude Sonnet 5.5——Claude 5.5 家族的第二个成员(第一个是 9 月 22 日的 Opus 5.5)。这次发布最反常识的地方在于:价目表一个数字都没动,但 Anthropic 声称完成同一任务的总成本最高能降 30%,输出速度还快了 30% 以上。
钱省在哪?不在单价,在"干活方式"。Sonnet 5.5 用更少的 token 和更少的工具调用就能完成同样的工作——这直接改变了你账单的结构,也改变了"哪个模型该干哪类活"的选型逻辑。本文把发布要点、基准数据、API 接入和迁移坑一次讲清。
一、发布速览:一张表看懂 Sonnet 5.5
| 项目 | Claude Sonnet 5.5 | 对照:Opus 5.5 | 对照:Sonnet 5 |
|---|---|---|---|
| 发布日期 | 2026-09-28 | 2026-09-22 | 2026-06-30 |
| API 模型 ID | claude-sonnet-5-5 |
claude-opus-5-5 |
claude-sonnet-5 |
| 输入 / 输出(每百万 token) | $2 / $10 | $4 / $20 | $2 / $10 |
| 缓存读 / 5 分钟缓存写 | $0.20 / $2.50 | $0.20 / $5.00 | $0.20 / $2.50 |
| 1 小时缓存写 | $4 | $8 | —— |
| 上下文 / 最大输出 | 1M / 128K | 1M / 128K | 1M / 128K |
| 思考模式 | 自适应思考默认开启 | 自适应思考默认开启 | 可配置 |
| Effort 档位 | low / medium / high / xhigh / max | 同左 | —— |
| API 默认 effort | high | 自适应 | —— |
几个要点:
- 价格与 Sonnet 5 完全一致,包括缓存价格。不用改预算表,直接换模型 ID 就能用。
- 五个重新标定的 effort 档位(low 到 max),默认在 Claude Code 和 Claude App 里是 medium,在 Claude Platform / API 里是 high。档位直接决定思考深度,也是控制单任务成本的第一旋钮。
- 已在 AWS、Google Cloud、Microsoft Azure 上线,提供 zero data retention 选项,企业合规路径和 Opus 5.5 相同。
- 可靠知识截止为 2026 年 6 月。Claude Haiku 5.5(面向高并发、成本敏感场景)将在未来几周加入家族。
二、基准与企业实测:便宜的那档,这次真的不慢
先看 Anthropic 官方公布的核心成绩:
| 基准 | Sonnet 5.5 | Opus 5.5 | Sonnet 5 |
|---|---|---|---|
| Terminal-Bench 4.0(Agent 编程) | 70.6% | 66.4%(Xhigh) | 10.3% |
| FrontierCode 1.1(Max / Xhigh) | 46.2% / 52.1% | 54.4% | 42.4% |
| CursorBench 4.0 | 55.5% | 57.8% | 34.1% |
| GDPval-AA v2.1(知识工作) | 1844 | 1846 | 1449 |
| AA-Briefcase v1.1 | 1811 | 1822 | 1359 |
| Humanity's Last Exam(带工具) | 64.5% | —— | —— |
Terminal-Bench 4.0 上从 10.3% 跳到 70.6%,是这次最夸张的数字;GDPval-AA 比 Sonnet 5 高了约 400 分,离 Opus 5.5 只差 2 分。
更值得关注的是企业侧的早期实测,因为它们测的是"任务成本"而不是榜单分:
- Balyasny Asset Management:2441 道金融任务上,每答案平均 12.1 万 token,Sonnet 5 是 49.7 万——token 消耗直接砍到约四分之一。
- Base44:118 次真实应用构建,平均 3.6 次迭代完成,Opus 5 需要 7.7 次,且失败工具调用最少。
- Slack:离线 Slackbot 评测输出 token 减少约 14%,提示词零改动。
- Zendesk:工单处理比现有 Claude 生产模型快 20%;Box:结果产出快 2.4 倍、总 token 少 12%;Atlassian:Rovo Agents 运行速度最高提升 30%。
但官方也明确说了边界:Opus 5.5 在需要持续判断力的复杂开放任务上仍然明显更强。Sonnet 5.5 的甜区是边界清晰的日常任务:修 bug、写文档、做幻灯片和表格、设计稿审查这类"有明确完成标准"的工作。
三、API 接入实操:十分钟跑通
Sonnet 5.5 走标准 Messages API,接入和其他 Claude 模型一致:
curl https://api.anthropic.com/v1/messages   -H "x-api-key: $ANTHROPIC_API_KEY"   -H "anthropic-version: 2023-06-01"   -H "content-type: application/json"   -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 8192,
    "thinking": { "type": "adaptive" },
    "messages": [
      { "role": "user", "content": "帮我把这段 Python 重写成 TypeScript,并列出你改动的每一处语义差异。" }
    ]
  }'
三个实用提示:
- effort 档位就是你最便宜的成本杠杆。对"有标准答案"的批量任务(代码审查、分类、摘要),先试 low 或 medium;只有结果不达标再升档。Balyasny 那种四分之一的 token 消耗,前提就是让模型在最够用的档位上干活。
- 缓存还是老配方。代码库上下文塞进 system 块并开缓存,5 分钟缓存写 $2.50、缓存读仅 $0.20,长会话场景务必用满。注意最小可缓存提示从 Sonnet 5 的 1024 token 降到了 512 token,短系统提示也能吃到缓存红利了。
- 零数据保留(ZDR)已可用,和 Opus 5.5 同级。金融、医疗等合规敏感场景可以直接谈这个档位。
四、从 Sonnet 5 迁移:4 个必踩的坑
如果你直接从 Sonnet 5 切模型 ID,有几处行为差异会咬人,官方迁移指南里点名了这几条:
- thinking disabled 会直接报 400。 自适应思考现在是默认且强制的,以前用
thinking: { "type": "disabled" }关闭思考的代码会报错。想压思考成本,改用between_tools档位——这是目前最低可用档。 - 强制工具选择(forced tool choice)被拒。 旧的"指定必须用某个工具"写法不再接受,要改成自动工具选择 + strict tools 的组合,让模型在结构化约束下自己决定调用。
- 最小可缓存 prompt 降为 512 token。 这算好消息:以前短提示凑不够 1024 token 吃不到缓存价,现在一半就能命中。
- 拒绝行为会变多。 新增了五类拒绝 stop-reason(cyber、bio、frontier_llm、reasoning_extraction、general_harms)。Sonnet 5.5 是首个搭载旗舰级网络安全防护的 Sonnet:高风险请求会静默回退到 Sonnet 5 执行,良性安全任务也可能被误伤——如果你在跑安全研究类工作流,先把这层预期加进测试集。
五、什么时候还该用 Opus 5.5
选型建议一张表收尾:
| 场景 | 推荐 |
|---|---|
| 边界清晰的批量任务:代码审查、工单分类、文档/表格生成 | Sonnet 5.5(medium) |
| Agent 编程、终端操作(Terminal-Bench 甜区) | Sonnet 5.5(high) |
| 需要持续判断力的复杂开放任务、长链路架构决策 | Opus 5.5 |
| 高并发、成本极度敏感 | 等 Haiku 5.5(数周内) |
常见问题
Q:账单上什么时候能看到"省 30%"? A:省的是任务总成本不是单价,前提是任务边界清晰、effort 档位设得克制。开放式任务上调到 xhigh/max 后,账单未必比 Opus 便宜多少——按自己的真实流量抽 5% 对比一周再下结论。
Q:Claude Code 里怎么切换?
A:默认 effort 就是 medium。想全局换模型,把配置里的模型 ID 改成 claude-sonnet-5-5 即可,无需其他改动。
Q:会回落到旧模型吗? A:只有一类情况:网络安全防护判定为高风险请求时,会回退到 Sonnet 5 执行。其余请求都由 Sonnet 5.5 本体处理。
小结
Sonnet 5.5 是 Anthropic 少见的"不加价、改结构"式升级:单价没变,但 Terminal-Bench 4.0 从 10.3% 跳到 70.6%、企业实测 token 消耗砍到四分之一,让"中杯"第一次在长上下文编程任务上具备了挑战"大杯"的性价比。今天就能做的事:把批量化任务的模型 ID 换成 claude-sonnet-5-5、用 effort 档位替代"关思考"的旧习惯、把 512 token 的缓存门槛用起来。复杂开放判断留给 Opus 5.5——它现在贵得有底气,也贵得更孤独了。