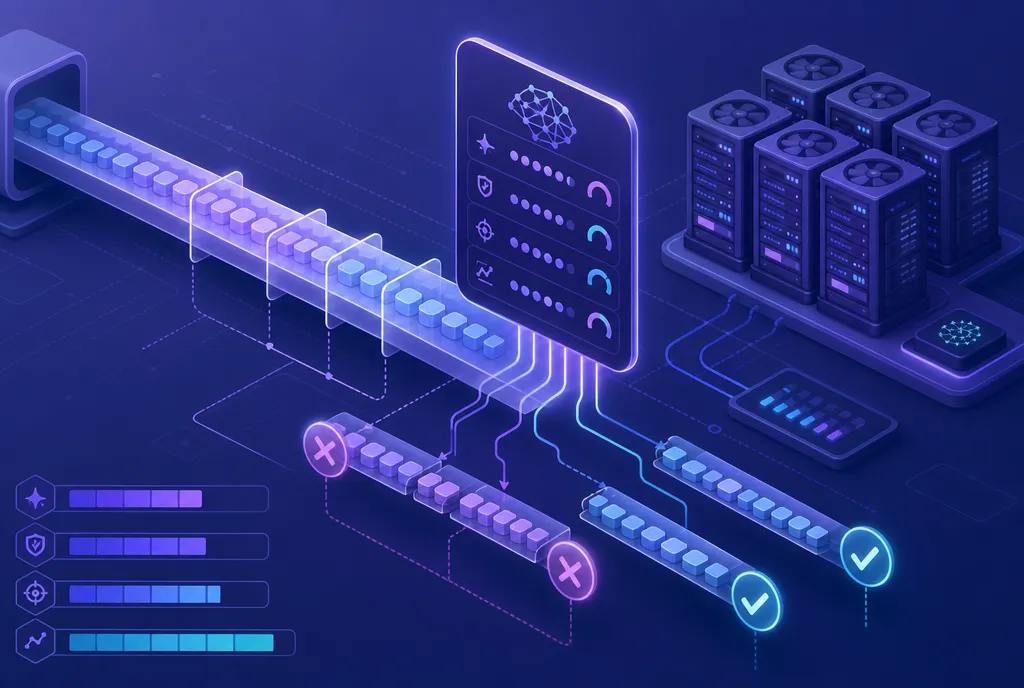
过去三天,AI 圈被一篇斯坦福 NLP 的论文反复转发:《Trust the Critic More》(arXiv:2609.39247,9 月 30 日首版、10 月 1 日修订)。它提出的 AC2(Actor-Critic with Action Chunking) 看起来只做了一件事:训练 LLM 的强化学习时,不再要求每条 rollout 都跑到终点。
但正是这个「不再要求」,戳中了当下后训练最大的成本痛点。
一、为什么「跑完每条 Rollout」这么贵
目前主流的 LLM 强化学习——GRPO 一族——是这么工作的:让模型对同一道题生成一整条完整回答(rollout),在终点用一个奖励信号(做对/做错、评分)给整条序列上所有 token 记同样的功劳或过错。想更新一次策略,就得先采样出大量完整轨迹。
问题在于,很多任务的轨迹极长:数学证明、代码修复、Agent 多步操作,一条轨迹几千到几万 token 是常态,而且大量轨迹「开局就注定失败」——前两步已经走偏,后面几千 token 全是在浪费解码算力。业内苦此久矣,但惯常认知是:学习到的 critic(价值评估模型)不够准,信它不如信终局奖励。
AC2 的立场正好相反:critic 不是不能信,是你得给它创造「值得信」的条件。
二、AC2 的三个核心设计
论文把信用分配(credit assignment)的粒度从「整条轨迹」改成「动作块」——从历史轨迹的某个前缀出发,续写一小段(约 1 万 token)就截断,由 critic 给这个块末端的状态打分,策略据此更新,全程不需要看到终局奖励。为了让 critic 的分数真正可靠,作者给了三个配套设计:
- Local Readiness(局部就绪):只在 critic 对某一道题足够准的时候,才在这道题上用 critic 打分更新。每道题的启用时机独立判断,避免「 critic 平均很准、但这题很烂」的灾难。
- Reference Solution(参考解):只要有历史成功 rollout 可用,就把它作为参考解喂给 critic。critic 不用凭空猜「这个状态值多少分」,而是对照「已知的成功路径」评估,难度骤降。
- Chunk 级打分:信用分配的单位是 10k token 的块而不是单个 token。critic 看到的是一段有语义的完整尝试,而不是一个孤立 token,评估信号质量高得多。
三、和 GRPO 的逐项对比
| 维度 | GRPO(主流基线) | AC2 |
|---|---|---|
| 信用分配粒度 | 整条轨迹,所有 token 共享同一 advantage | 1 万 token 动作块,块级打分 |
| 是否必须跑完 rollout | 是,每条轨迹都要到终局奖励 | 否,块末状态打分即可更新 |
| critic 的角色 | 即便存在也只做 baseline 估计 | 直接作为更新信号的来源 |
| 实测结果 | Qwen3-4B / FineProofs-RL 峰值验证分 18.5%(IMO-ProofBench) | 超过 18.5%,且 decoding FLOPs 省 2.5 倍 |
| 省算力的来源 | — | 训练步数少 25% + 每步生成的 token 更少 |
省 2.5 倍 decoding FLOPs 这个数字值得拆开看:一部分来自收敛更快(到达同一分数少用 25% 的训练步),另一部分来自每一步内生成的 token 变少——因为注定走不通的轨迹可以提前停掉,不用陪跑到底。对按 token 计费的训练集群来说,这两头都是真金白银。
四、你的 RL 管线今天就能检查的清单
就算不立刻换掉 GRPO,AC2 的思路也值得用来做一轮管线体检:
□ 统计你的 rollout 长度分布:多少轨迹在开头 20% 就已偏离?
□ 如果 ≥30% 的轨迹「开局即失败」,你就有巨大的提前终止收益空间
□ 检查 reward 是否真的只在终点给出——能否改造成中间态可评估
□ 给 critic 加「按题目/按任务类型」的准确率监控,而不只看全局指标
□ 保留成功 rollout 作为参考解库,评估 critic 时优先检索注入
□ A/B 方式验证:先在一个小规模任务上对比 GRPO vs 块级打分
一个最小可行实验的设计:选一个轨迹长、终点 reward 明确的任务(数学证明、单元测试修复都合适),把轨迹按固定 token 数切块,先只做监控——用 critic 给每块打分,对比「critic 低分块」与「最终失败轨迹」的重合率。如果高分块大多活到最后、critic 低分块大多以失败告终,说明你的 critic 已经具备局部可信度,改造的前提就成立了。
五、注意事项与常见问题
Q:这是新框架吗?能直接 pip install 吗? 目前它是一篇论文 + 一个方法论,作者公开的评测设置是 Qwen3-4B + FineProofs-RL → IMO-ProofBench。是否放出实现、能否直接复用到你的框架,请以 arXiv 页面和作者后续更新为准。把它当「设计范式」吸收,比当「现成工具」等待更有价值。
Q:critic 打分不准怎么办?这难道不是老问题? 这正是 AC2 和以往 actor-critic 尝试的区别:它不假设 critic 全局都准,而是用 Local Readiness 逐题把关、用参考解降低评估难度、用 10k 粒度的块换取语义完整性。三管齐下,critic 才第一次变得「可信任」。
Q:只适合数学证明任务吗? 论文实验集中在推理/证明类任务,因为这类任务轨迹长、终点 reward 明确、参考解好构造。但「轨迹长 + 中间状态可评估」是 Agent、代码、规划类任务的共性,论文自己也将结论表述为:不必跑完每条轨迹这件事一旦成立,LLM RL 的整个设计空间都被打开了。
Q:普通应用开发者需要关心吗? 短期不需要改任何线上代码。但如果你在采购微调/后训练服务,或在评估自建训练管线,「rollout 完成率」「critic 局部准确率」会成为新的议价与选型指标——这是这条论文对工程侧最实际的影响。
六、小结
AC2 的贡献可以浓缩成一句话:当 critic 被认真对待时,LLM 强化学习可以摆脱「每条轨迹必须跑完」的枷锁。三个设计——逐题的就绪判断、参考解辅助、块级粒度——分别解决了「哪敢信」「怎么信」「信多细」三个问题,最终换来 2.5 倍的解码算力节省。本周的行动建议:先跑第四节那个「critic 低分块 vs 最终失败」的重合率实验,用你自己的数据判断这波范式转移离你有多近。